Vérification d’âge et SEO : le guide pour les sites adultes
Vous préparez un contrôle d’âge et vous craignez pour votre référencement ? Le point décisif est ce que votre site envoie réellement à Google. Voici comment organiser l’accès, repérer les erreurs et vérifier le résultat.
La vérification d’âge peut-elle nuire au référencement ?
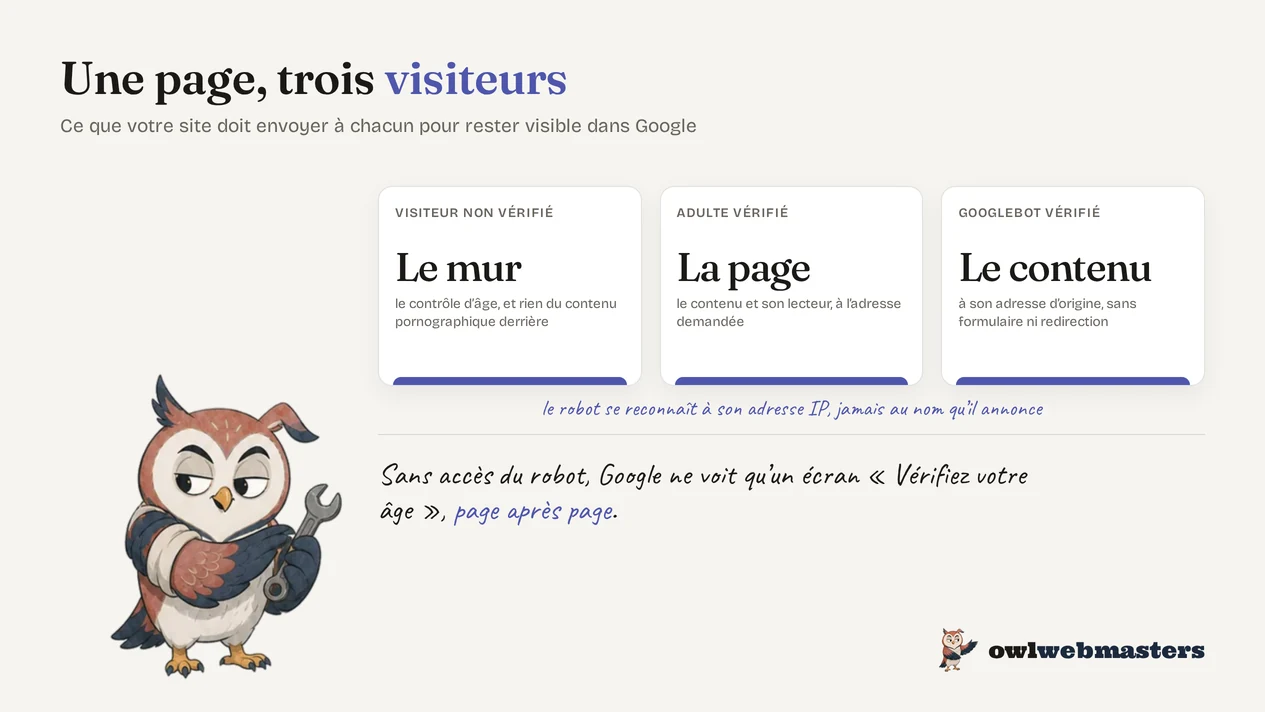
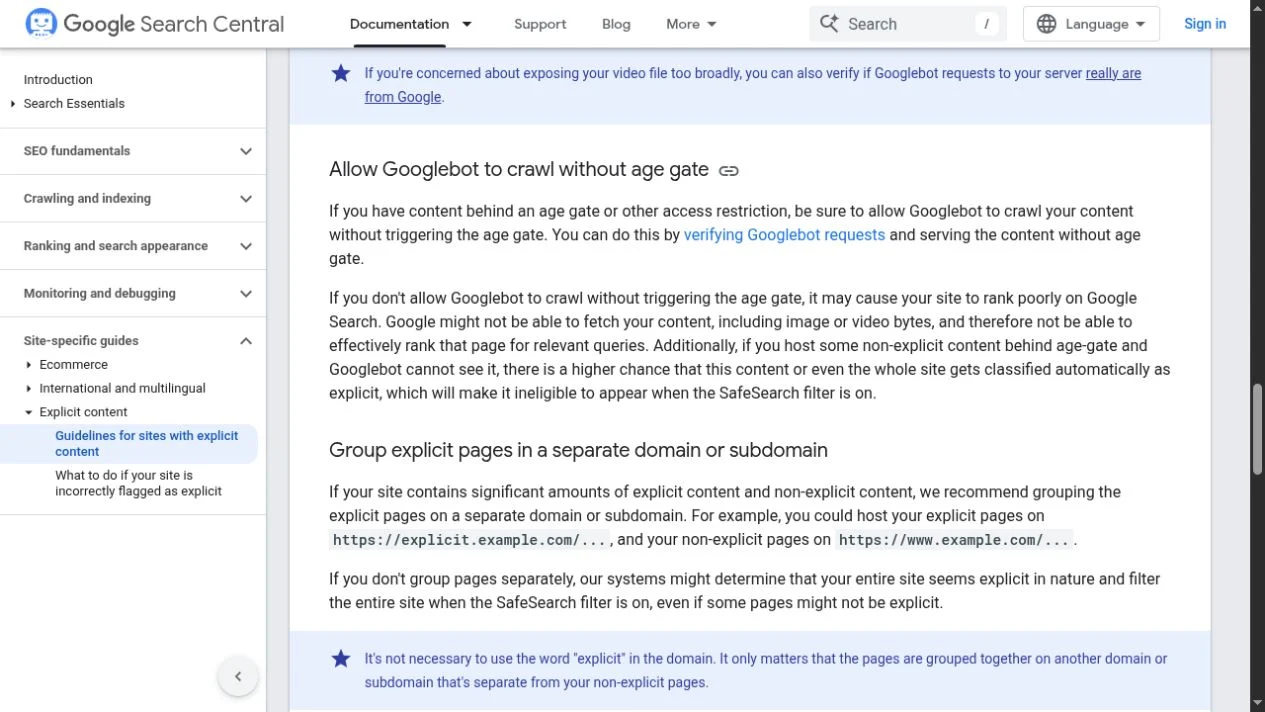
Oui, si elle empêche Google d’accéder aux pages. Mais un contrôle d’âge n’exclut pas automatiquement un site des résultats de recherche. Google documente précisément cette situation : son robot doit pouvoir explorer le contenu sans passer par la vérification imposée aux visiteurs, après validation de son identité.
Imaginez une page vidéo avec un titre, une description et un lecteur. Si Google reçoit à la place un écran « Vérifiez votre âge », il ne voit plus les éléments qui permettent de comprendre cette page. Répéter le même écran sur tout le catalogue peut donc affecter la visibilité de nombreuses URL.
Pour diagnostiquer le problème, distinguez trois choses :
- L’exploration. Google peut-il récupérer la page et ses ressources ?
- L’indexation. A-t-il retenu cette page dans son index ? Une page accessible n’est pas forcément indexée.
- Le classement et le filtrage. Pour quelles recherches apparaît-elle, et avec quels réglages SafeSearch ?
Une baisse de trafic après l’installation mérite une enquête, mais elle ne prouve pas que le contrôle d’âge est responsable. Commencez par regarder ce que Google reçoit, puis comparez les pages concernées et les dates des changements.
Une même page, trois situations à prévoir
Prenons une adresse fictive, /videos/exemple/, que vous souhaitez rendre visible dans la recherche. Le contenu ne change pas de sujet selon celui qui le demande. C’est l’autorisation d’y accéder qui change.
| Qui demande la page ? | Résultat attendu |
|---|---|
| Un visiteur non vérifié | Il rencontre le contrôle d’âge. Les contenus pornographiques restent inaccessibles tant que la vérification exigée n’a pas abouti. |
| Un adulte autorisé | Il retrouve la page demandée, avec son contenu et son lecteur, sans être renvoyé inutilement à l’accueil. |
| Googlebot vérifié | Il accède au contenu destiné à la recherche, à son URL d’origine, sans formulaire d’âge ni redirection vers celui-ci. |
C’est le principe des consignes de Google pour les sites avec contrôle d’âge. L’accès du robot doit aussi couvrir les ressources nécessaires, notamment les images et les fichiers vidéo concernés. Une page dont seul le titre est accessible ne suffit pas à vérifier le fonctionnement de l’ensemble.
Cette exception concerne le contenu que vous voulez faire explorer. Elle ne justifie pas d’ouvrir les comptes, les données privées ou l’administration aux robots.
Installer un contrôle d’âge qui protège réellement l’accès
Commencez par les exigences applicables à votre activité et aux pays desservis. Le choix d’une fenêtre, d’une page intermédiaire ou d’un prestataire vient ensuite. Une interface qui affiche « 18+ » ne dit rien, à elle seule, sur la manière dont l’âge est vérifié.
En France, le référentiel de l’Arcom prévoit, pour les services visés, un écran d’accueil sans contenu pornographique et un accès empêché avant la vérification de majorité. Une simple case déclarative ne suffit pas. Au Royaume-Uni, Ofcom impose une assurance de l’âge hautement efficace aux services concernés qui permettent l’accès à de la pornographie. Les règles de Google ne remplacent pas ces obligations.
Une page de vérification séparée
Le visiteur quitte temporairement la page demandée pour effectuer le contrôle, puis y revient après validation. Ce parcours peut fonctionner, à condition que le robot vérifié reçoive directement la page de départ. Faites aussi le test depuis un lien profond, comme une fiche vidéo, et pas seulement depuis l’accueil.
Une fenêtre affichée sur la page
Une fenêtre peut servir d’interface au contrôle. En revanche, si les fichiers protégés ont déjà été envoyés au navigateur, les masquer visuellement ne les rend pas inaccessibles. Le serveur doit appliquer les autorisations aux contenus concernés, y compris lorsque leurs URL sont demandées directement.
Sur WordPress comme sur un site développé sur mesure, demandez donc comment l’intégration gère trois points : la validation du visiteur, l’identification du robot et le cache. Le nom d’une extension ou une option « compatible SEO » ne répond pas à ces questions. Faites préciser le comportement réel sur une page et ses médias.
Comment reconnaître le vrai Googlebot ?
Googlebot annonce son nom dans le User-Agent, un identifiant envoyé avec la requête. Cet identifiant est facile à imiter. Il ne doit jamais suffire à retirer le contrôle d’âge.
La vérification repose sur l’adresse IP à l’origine de la demande. Google publie les plages utilisées par ses robots communs, dont Googlebot. Votre équipe technique peut comparer l’IP à cette liste tenue à jour. Il existe aussi une méthode de contrôle par DNS, détaillée ci-dessous.
Pour l’intégration technique : les contrôles IP et DNS
Utilisez la liste officielle common-crawlers.json pour les robots concernés de cette catégorie. Les autres listes de Google correspondent à d’autres usages. Autoriser toutes les adresses hébergées chez Google serait trop large.
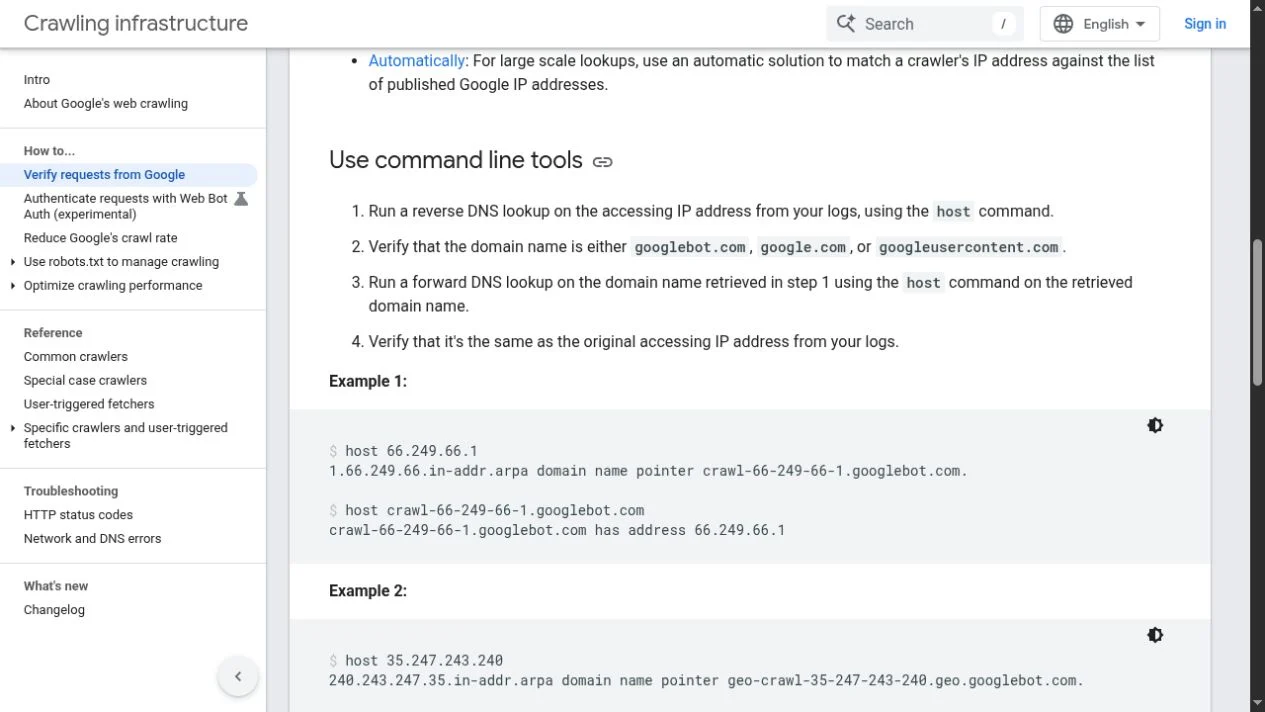
Pour vérifier une requête par DNS, suivez les trois étapes de la documentation :
- Retrouver le nom d’hôte associé à l’adresse IP avec une résolution DNS inverse.
- Contrôler le domaine attendu pour le robot. Pour Googlebot, les noms publiés se trouvent sous
googlebot.com, y comprisgeo.googlebot.com. - Résoudre ce nom dans l’autre sens et confirmer que la réponse contient l’adresse IP de départ.
Vérifiez le domaine complet avec sa limite de suffixe. Un nom comme googlebot.com.example.net n’appartient pas à Googlebot. Une concordance entre les deux résolutions ne suffit pas si le domaine n’a pas été contrôlé.
Si un CDN ou un proxy relaie les demandes, récupérez l’IP d’origine uniquement depuis un relais configuré comme fiable. N’accordez pas l’accès à partir d’un en-tête que n’importe quel client peut fournir. Prévoyez aussi le traitement des erreurs DNS sans ouvrir l’accès par défaut.
Vous pouvez confier cette partie à votre développeur ou à votre hébergeur. Demandez-lui de montrer, dans les journaux du serveur, une requête Google vérifiée et la réponse obtenue. Le test doit aussi confirmer qu’une requête ordinaire qui se présente comme Googlebot reste soumise au contrôle.
Les erreurs qui peuvent gâcher l’installation
Envoyer Google vers le formulaire
Ouvrir le site dans votre navigateur ne suffit pas : vous avez peut-être déjà validé votre âge. Pendant ce temps, Google peut être redirigé vers la même page de contrôle à chaque visite. Vérifiez l’URL finale et le contenu renvoyé au robot, même si le serveur répond avec un code 200.
Préparer une version artificielle pour le robot
L’exception prévue pour le contrôle d’âge n’autorise pas à fabriquer une page remplie de mots-clés que les visiteurs ne verront jamais. Google qualifie de cloaking la présentation trompeuse de contenus différents destinée à manipuler le classement. Le robot doit retrouver le contenu accessible au visiteur autorisé.
Oublier les images et les vidéos
La page peut être accessible alors que le serveur de médias refuse les fichiers à Google. Contrôlez les vignettes, la vidéo et les éventuels domaines de diffusion séparément. Google indique que l’impossibilité de récupérer les vidéos explicites peut affecter le classement, notamment dans les résultats vidéo.
Laisser le cache mélanger les réponses
Un cache conserve des réponses pour les réutiliser. S’il ne tient pas compte des autorisations, il peut envoyer l’écran de contrôle à Google ou, à l’inverse, une réponse protégée à un visiteur non vérifié. Testez ces deux situations, y compris après le passage d’un adulte autorisé et après celui du robot.
Confondre protection et consignes d’indexation
Un blocage dans robots.txt peut empêcher l’exploration. Une directive noindex demande de ne pas indexer la page. Aucune de ces consignes ne vérifie l’âge des visiteurs. Contrôlez qu’elles ne touchent pas par erreur les pages que vous souhaitez voir apparaître dans Google.
SafeSearch et indexation : deux sujets différents
Une page peut être indexée et rester absente des résultats lorsque SafeSearch est réglé sur Filtrer. Ce n’est pas la même chose qu’une page que Google n’arrive pas à explorer. Pour un site adulte, l’objectif est que le moteur comprenne correctement le contenu et respecte les préférences de recherche.
Cette distinction compte aussi pour les pages non explicites. Si Google ne peut pas les lire derrière le contrôle d’âge, il risque de les classer comme explicites avec le reste du site.
Lorsqu’un site réunit des volumes importants de contenus explicites et non explicites, Google recommande de placer les premiers sur un domaine ou un sous-domaine distinct. Cette organisation peut aider à distinguer, par exemple, un catalogue adulte d’un espace documentaire non explicite. Elle ne garantit pas la classification de chaque page.
Quelle balise mettre sur les pages adultes ?
Google recommande le marquage suivant pour les pages sexuellement explicites. Il se place dans la partie <head> du HTML :
<meta name="rating" content="adult">La balise RTA est une alternative reconnue :
<meta name="rating" content="RTA-5042-1996-1400-1577-RTA">Une seule des deux suffit. Ce marquage aide Google à identifier le contenu explicite pour SafeSearch. Il ne remplace ni la vérification d’âge ni le contrôle d’accès, et ce n’est pas une astuce pour gagner des positions.
Si votre site publie aussi des pages non explicites, vérifiez que le modèle de page n’ajoute pas cette balise indistinctement partout.
Comment tester avant et après la mise en ligne ?
Préparez un petit échantillon représentatif : l’accueil, une page de catalogue, une fiche vidéo et une page non explicite si vous en avez. Notez leur état d’indexation avant le changement. Vous disposerez ainsi de points de comparaison précis.
Avant l’ouverture : vérifier l’accès réel
- Sans validation d’âge : ouvrir chaque URL dans une nouvelle session et demander directement les médias protégés. Ils doivent rester inaccessibles.
- Après validation : revenir sur la page initialement demandée, vérifier son contenu et lancer le lecteur sur ordinateur et mobile.
- Avec les règles prévues pour Google : faire contrôler l’identification des requêtes, les redirections, les fichiers accessibles et la séparation du cache.
Effectuez ces essais dans l’environnement de test, puis confirmez-les en production. Les règles du CDN et du serveur public peuvent différer de celles de votre installation locale.
Après le déploiement : contrôler dans la Search Console
- Inspecter une URL précise. Lire les informations connues de Google et la date de dernière exploration.
- Lancer le test de l’URL active. Il vérifie la version actuellement servie, qui peut différer de celle du dernier passage du robot.
- Examiner la page testée. Consulter le HTML, la capture lorsqu’elle est disponible et les ressources chargées. Chercher le vrai contenu de la page, pas seulement un message d’accès réussi.
- Comparer avec les journaux du serveur. Rechercher les refus d’accès, les redirections et les erreurs sur les médias aux heures des tests et des passages de Googlebot.
Un détail utile : les outils de test utilisent notamment Google-InspectionTool, un identifiant distinct de Googlebot. Si leurs résultats diffèrent, faites vérifier les règles appliquées à chacun et leur authentification. Autoriser l’outil de test ne suffit pas à autoriser le robot de recherche.
Un test positif confirme des points techniques, pas une position dans Google. Après correction, vous pouvez demander une nouvelle indexation, puis suivre les pages concernées dans les rapports d’indexation et de performances. Si le trafic baisse, distinguez la perte de visibilité dans la recherche d’un abandon des visiteurs pendant le contrôle d’âge.
Gardez une trace des URL testées, des réglages et de la date d’installation. Au prochain changement d’extension, de prestataire ou de CDN, vous pourrez refaire les mêmes contrôles et repérer rapidement ce qui a changé.
Si le site n’existe pas encore, le guide pour créer son premier site porno replace la vérification d’âge parmi les huit décisions à prendre avant le lancement.
Sources
Sources officielles consultées le 6 septembre 2026. Les exemples de parcours et la liste de contrôles sont notre mise en pratique de ces recommandations.
- Google Search Central : contenus explicites, contrôle d’âge et SafeSearch
- Google : vérifier l’origine des requêtes
- Google : plages IP des robots communs
- Google : rôle de Google-InspectionTool
- Google Search Central : règles sur la dissimulation
- Search Console : utiliser l’inspection d’URL
- Arcom : référentiel technique de vérification de l’âge
- Ofcom : exigences pour les services proposant de la pornographie
Ce guide traite du référencement et des contrôles techniques. Les obligations de votre service doivent être évaluées selon sa situation et les pays concernés.